Die meisten Online-Händler reagieren auf Retouren erst, wenn das Paket schon beim Kunden angekommen ist und das Ticket im Postfach liegt. Dabei läßt sich ein großer Teil der Rücksendungen vorhersagen, bevor die Ware überhaupt das Lager verläßt. Wer nur auf Abarbeitung optimiert, Rücksendelabel schneller ausstellen, Tickets schneller beantworten, der kuriert ein Symptom. Das eigentliche Hebelpotential liegt in der Priorisierung und Vorhersage, und genau da wird der Markt gerade in Bewegung versetzt.
Warum reine Retourenbearbeitung nicht mehr reicht
Retourenmanagement im E-Commerce wurde jahrelang als reines Abwicklungsproblem behandelt: Label generieren, Wareneingang buchen, Erstattung auslösen, Ticket schließen. Das ist im wesentlichen ein Nachsorge-Prozess. Er kostet Geld, aber er verhindert keine einzige Retoure.
Gleichzeitig beobachten wir aktuell, wie Anbieter wie ParcelLab mit einem Ansatz namens „Pre-Turn" in den Markt drängen, bei dem Retouren bereits vor der Zustellung erkannt und bearbeitet werden sollen. Das erhöht den Innovationsdruck für alle Händler, die noch rein reaktiv arbeiten. Wer jetzt nicht anfängt, Retourenwahrscheinlichkeit in seine Prozesse einzubauen, läßt Wettbewerbsvorteile liegen, die sich in den nächsten 12 bis 24 Monaten zum Standard entwickeln dürften.
Der Punkt ist nicht, dass Sie ein Tool wie Pre-Turn kaufen müssen. Der Punkt ist, dass die zugrundeliegende Logik, nämlich Retourenwahrscheinlichkeit aus vorhandenen Daten abzuleiten, mit Standard-Automatisierungswerkzeugen bereits heute umsetzbar ist, ohne dass Sie dafür eine neue Enterprise-Plattform einführen müssen.
Welche Daten zeigen schon vor der Retoure, dass sie kommt?
Die meisten Online-Händler sitzen auf Daten, die sie nicht auswerten:
- Artikel-Historie: Bestimmte SKUs, insbesondere bei Mode und Schuhen, haben Retourenquoten von 30 bis 50 Prozent, andere liegen bei unter 5 Prozent. Diese Differenz wird selten systematisch in die Kundenkommunikation eingebaut.
- Bestellverhalten: Kunden, die mehrere Größen oder Farben derselben Ware gleichzeitig bestellen, retournieren mit deutlich höherer Wahrscheinlichkeit einen Teil der Sendung.
- Kundenhistorie: Ein kleiner Teil der Kundschaft ist für einen überproportionalen Anteil der Retouren verantwortlich, typischerweise im Mode-Segment.
- Saisonale Muster: Nach Rabattaktionen und in der Weihnachtszeit steigt die Retourenquote in der Regel meßbar an.
Diese Signale liegen in der Regel verstreut in Shopsystem, ERP und Zahlungsdienstleister. Ein KI-Workflow kann sie zusammenführen und daraus eine Priorisierung ableiten: Welche Bestellungen brauchen proaktive Kommunikation, welche Retourentickets können vollautomatisch bearbeitet werden, und welche Fälle sollten tatsächlich an einen Menschen gehen.
Wie sieht ein vorhersagebasierter Retourenprozess konkret aus?
Statt alle Retouren gleich zu behandeln, läßt sich der Prozess in drei Stufen aufteilen:
- Stufe 1, präventiv: Bei Artikeln mit hoher Retourenwahrscheinlichkeit erhält der Kunde vor Versand automatisch zusätzliche Größeninformationen oder einen Hinweis auf die Passform. Das reduziert die Retourenquote selbst, bevor überhaupt etwas zurückgeschickt wird.
- Stufe 2, automatisierte Abwicklung: Standardfälle, defekte Ware, falsche Größe bei einfachen Produkten, Nichtgefallen bei Artikeln unter einem definierten Warenwert, werden vollautomatisch verarbeitet: Label erstellt, Erstattung ausgelöst, Bestätigungsmail verschickt. Kein Mensch muß das Ticket je anfassen.
- Stufe 3, priorisierte Bearbeitung: Komplexe Fälle, hochpreisige Artikel, Kunden mit auffälligem Retourenmuster oder Reklamationen mit unklarem Sachverhalt werden an den Kundenservice weitergeleitet, aber mit vorausgefüllten Informationen: Bestellhistorie, Retourengrund, Vorschlag für die Lösung.
Der Unterschied zur reinen Ticketautomatisierung: Hier wird nicht nur schneller abgearbeitet, sondern das Volumen an Stufe-3-Fällen wird von vornherein kleiner gehalten, weil Stufe 1 und 2 einen Großteil abfangen.
Modellrechnung: Online-Händler mit 4.000 Bestellungen im Monat
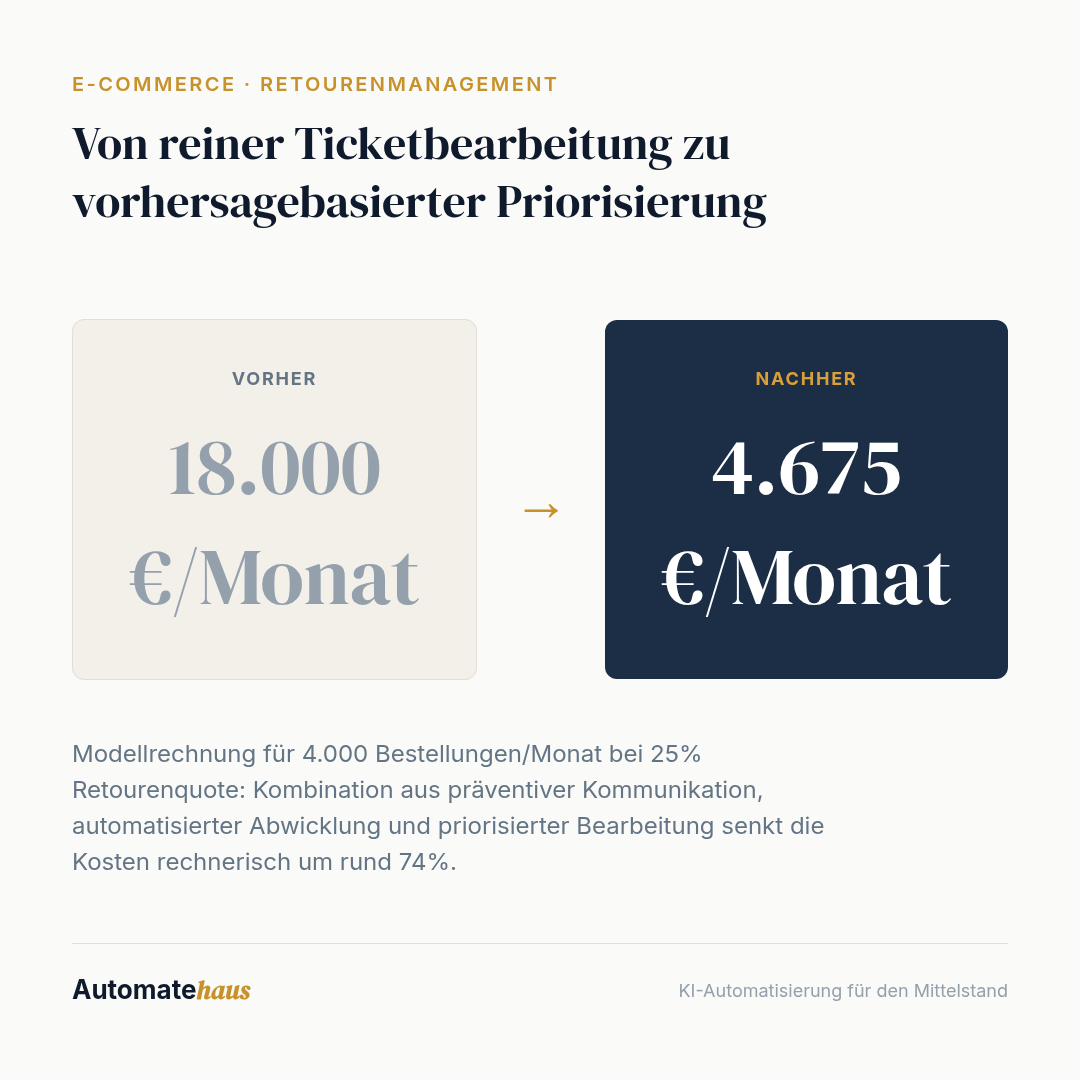
Rechnen wir das an einem Online-Händler im Mode-Segment mit rund 4.000 Bestellungen pro Monat durch. Nehmen wir an, die durchschnittliche Retourenquote liegt bei 25 Prozent, das ergibt etwa 1.000 Retouren im Monat. Ohne Priorisierung landet praktisch jede dieser Retouren irgendwann als Ticket beim Kundenservice, sei es für die Abwicklung selbst oder für Rückfragen zum Status.
Nehmen wir weiter an, die Bearbeitung eines Tickets kostet im Schnitt 18 Euro, wenn man Personalzeit, Softwarekosten und Fehlerquote einrechnet. Das ergäbe bei 1.000 Retouren Kosten von 18.000 Euro im Monat.
Legen wir nun die dreistufige Logik zugrunde: Angenommen, Stufe 1 (präventive Kommunikation bei risikobehafteten Artikeln) senkt die Retourenquote selbst um 15 Prozent, das wären rund 150 vermiedene Retouren. Von den verbleibenden 850 Fällen könnten laut unserer Annahme etwa 70 Prozent vollautomatisch in Stufe 2 abgewickelt werden, das sind 595 Fälle zu geschätzten 4 Euro pro Fall (reine Systemkosten ohne Personalzeit). Die verbleibenden 255 Fälle gehen in die priorisierte Bearbeitung, hier sinkt die Bearbeitungszeit laut Annahme durch vorausgefüllte Informationen um rund 60 Prozent, die Kosten pro Fall würden dann bei etwa 9 statt 18 Euro liegen.
Rechnerisch ergäbe das: 595 × 4 Euro plus 255 × 9 Euro, macht zusammen 2.380 Euro plus 2.295 Euro, also rund 4.675 Euro im Monat statt 18.000 Euro. Eine Ersparnis von über 13.000 Euro im Monat, allein durch die Kombination aus Vermeidung, Automatisierung und Priorisierung. Diese Zahlen sind eine Modellrechnung mit frei gewählten Annahmen, keine gemessenen Werte, aber sie zeigen die Größenordnung des Hebels, wenn man nicht nur die Bearbeitung, sondern auch die Vorhersage angeht.
Was braucht man technisch dafür, und wo liegen die Grenzen?
Für diesen Ansatz braucht es keine neue Enterprise-Software. Die Kombination aus Make.com oder n8n für die Workflow-Logik, einer Anbindung an Shopsystem und ERP sowie Claude AI für die Auswertung von Freitext in Retourenbegründungen reicht in der Regel aus. Wichtig ist die Datenbasis: Ohne saubere historische Daten zu Artikeln, Kunden und Retourengründen läßt sich keine verläßliche Priorisierung aufbauen.
Die Grenzen sind auch klar zu benennen: Bei neuen Produkten ohne Historie funktioniert die Vorhersage schlechter, hier muß man zunächst mit Kategorie-Durchschnittswerten arbeiten. Und bei Zahlungsdaten oder Bonitätsinformationen gilt es, die DSGVO-Vorgaben strikt einzuhalten, insbesondere wenn Kundenverhalten zur Risikobewertung herangezogen wird. Ein Auftragsverarbeitungsvertrag (AVV) und eine transparente Dokumentation der Verarbeitungslogik sind hier Pflicht, nicht Kür.
So läuft die Einführung ab
Eine vorhersagebasierte Retourenlogik läßt sich typischerweise in vier bis sechs Wochen aufbauen, abhängig von der Datenlage:
- Woche 1: Analyse der vorhandenen Retourendaten aus Shopsystem und ERP, Identifikation der Risikofaktoren (Artikel, Kunde, Bestellmuster). Der Händler liefert Zugriff auf die Systeme, AutomateHaus übernimmt die Auswertung.
- Woche 2: Aufbau der Workflow-Logik für Stufe 1 (präventive Kommunikation) und Stufe 2 (automatisierte Abwicklung) in Make.com oder n8n, Anbindung an die bestehende Shop- und Versandsoftware.
- Woche 3: Integration der KI-gestützten Textauswertung für Retourengründe und Priorisierung der Stufe-3-Fälle, Testlauf mit echten, aber begrenzten Datenmengen.
- Woche 4: Produktivsetzung mit laufender Beobachtung, Nachjustierung der Schwellenwerte für die Priorisierung basierend auf den ersten echten Ergebnissen.
AutomateHaus baut diese Systeme ohne Vendor-Lock-in auf: Sie bleiben Eigentümer der Workflows und Daten, die Tools sind Standard-Software, keine proprietäre Blackbox. Die Einführung erfolgt remote, DSGVO-konform inklusive AVV, und läßt sich schrittweise erweitern, etwa um weitere Vertriebskanäle oder zusätzliche Produktkategorien.
FAQ
Lohnt sich Retourenvorhersage auch für kleinere Online-Shops?
Ab etwa 1.000 bis 1.500 Bestellungen im Monat läßt sich meist schon genug Datenbasis aufbauen, um Muster zu erkennen. Bei kleineren Shops lohnt sich zunächst die einfachere Automatisierung der Stufe 2 (vollautomatische Abwicklung von Standardfällen), die Vorhersagelogik kann später ergänzt werden, sobald mehr Historie vorliegt.
Wie unterscheidet sich das von reinen Chatbot-Lösungen für den Kundenservice?
Ein Chatbot beantwortet Anfragen schneller, verhindert aber keine Retoure und verändert nicht, welche Fälle überhaupt beim Kundenservice landen. Die hier beschriebene Logik setzt früher an: Sie reduziert die Anzahl der Fälle, die überhaupt bearbeitet werden müssen, und sortiert die verbleibenden nach Komplexität vor.
Was passiert, wenn die Vorhersage falsch liegt?
Die Priorisierung ist eine Wahrscheinlichkeitsaussage, keine Garantie. Deshalb bleibt bei Stufe 3 immer ein Mensch in der Entscheidung, und auch bei Stufe 2 gibt es in der Regel eine Eskalationslogik, falls ein Kunde widerspricht oder der Fall von der erwarteten Norm abweicht. Das System wird über die Zeit nachjustiert, je mehr echte Fälle durchlaufen sind.
Wer Retourenmanagement nur als Kostenstelle betrachtet, optimiert am falschen Ende. AutomateHaus baut Systeme, die Retouren vorhersagen, bevor sie entstehen, und die verbleibenden Fälle so priorisieren, dass Kundenservice-Teams ohne Personalaufbau auch bei steigendem Bestellvolumen handlungsfähig bleiben.